目錄(18 節)
廣東話 AI 客服點樣砌?語音 Agent 由零到上線嘅工程拆解
廣東話 AI 客服唔係接個語音 API 就得。本文把工程拆成十個位:場景切分、架構選擇、粵語四類難句、延遲預算、每通話成本、barge-in、轉真人、PDPO 合規、上線四步,每個位都有驗收方法。
一句答你: 廣東話 AI 客服難唔難,唔關「語音引擎勁唔勁」咁簡單。難嘅係三件事:粵語聽唔聽得明、反應快唔快、俾人打斷嗰下收唔收得乾淨。
如果你今日攞到嘅任務係「公司想做廣東話客服」,你會即刻撞到一連串似是而非嘅問題:
- 應該由邊個場景開始?
- 客戶講完之後,系統要等幾耐先出聲?
- 客戶中途插嘴,系統應該停定繼續講?
- 錄音可以留幾耐?幾時要轉真人?
呢篇唔會賣你一個「一鍵開通」方案。佢會將成件事拆成十個工程位,每個位都有「做到乜先算完成」嘅判斷。你可以直接拎去做技術評審。
重點摘要
- 客服唔一定需要成個對話代理。分流、對話式查詢、真人助攻三種形態,成本同風險差一個數量級。
- 分段式架構(聽 → 諗 → 講)仍然是客服主流。原因好簡單:每段可以獨立換、獨立量、獨立報價。
- 粵語嘅難點唔平均。中英夾雜、港式英文、數字、懶音,四類佔咗大部分實務錯誤。
- 延遲要分五段量,而且要睇分佈,唔好睇平均。用家記住嘅係最差嗰幾次。
- 成本有兩塊:語音辨識按音頻秒計,語音合成按字符計入方案配額。
- 俾人打斷嗰下要即刻收手,仲要清走未播放嘅緩衝。淨係停生成,客人仲會聽到殘留嘅半句。
- 轉真人要帶脈絡。唔好叫客人由頭再講一次。
- 合規要寫入流程:錄音告知、保留期、投訴轉真人。三樣都唔可以上線後補。
先分清你要解嘅係邊一層
語音代理(voice agent) 係指一條可以聽、可以諗、可以講嘅電話線。客人講嘢,系統聽完、諗好答案,再用聲音讀出嚟。
但「語音客服」呢四個字,其實包住三件差好遠嘅工程。
| 形態 | 系統做咩 | 風險 | 適合邊個起步 |
|---|---|---|---|
| 分流 | 聽到查詢類型,跳去對應選單 | 低。答錯都係轉去真人 | 大部分公司第一步 |
| 對話式查詢 | 問答題,答案來自你核准嘅資料 | 中。答錯等於講錯嘢 | 答案穩定嘅場景 |
| 真人助攻 | 通話期間出逐字稿同建議答案 | 低到中。決定權仍在人 | 新人培訓、投訴前線 |
【獨家觀察】 好嘅客服項目,失敗通常唔係技術做唔到,而係第一步就揀咗最難嗰個場景。答案穩定嘅查詢,係最抵嘅第一場仗。
實務上,語音方案嘅完整能力清單喺廣東話 AI 客服一頁有齊。而家呢度想講嘅係工程視角:點樣由零砌起。
如果要一份由台詞庫到上線嘅實務流程,可以睇AI 客服語音入門。想知選單點設計,先睇粵語 AI IVR 設計。
場景切分:三個篩選條件
拎最近三個月嘅通話紀錄,逐條打標籤。只有同時符合三個條件嘅查詢,先值得做:
- 高重複 — 同一個問題每星期出現幾十次。
- 低風險 — 答錯唔會造成錢財或合規損失。
- 答案穩定 — 唔會因為政策改變而要即刻更新。
三個條件缺一不可。答覆會變嘅查詢,應該先做「真人助攻」,唔好一開始就交畀對話代理。
架構點揀:點解客服多數仍然行分段式
分段式(cascaded) 係指系統拆成三層:語音辨識將聲音變文字,語言模型將文字變答案,語音合成將答案變聲音。每一層都可以獨立替換同獨立量度。
另一條路係一體化(speech-to-speech):一個模型直接由聲音出聲音。聽落好靚,實際落地有兩個現實問題。
| 比較項 | 分段式 | 一體化 |
|---|---|---|
| 每段可否獨立換 | 可以 | 唔可以 |
| 延遲可否分段量 | 可以 | 較難 |
| 粵語詞表可否中途加入 | 可以 | 視乎方案 |
| 供應商更換成本 | 低 | 高 |
| 公開工程驗證 | 大量 | 較少 |
一個公開嘅電訊場景語音代理測試,用正係分段式:串流語音辨識、量化語言模型、知識檢索同一個即時語音合成,仲加咗一句級串流同並行執行,令第一個音頻位元提早出現。論文報告嘅分段平均延遲係:語音辨識 0.049 秒、檢索 0.008 秒、回應生成 0.670 秒、語音合成 0.286 秒,端到端平均 0.934 秒(見 arXiv:2508.04721,2025 年 8 月)。同一批研究亦指出,點解分段要逐段量、唔可以只睇總數:工具本身可以逐回合顯示每個模組嘅延遲指標(ESPnet-SDS,NAACL 2025 demo)。
【獨家觀察】 對客服嚟講,分段式仲有一個冇人明講嘅好處:每層都係可替換嘅商品,唔使同一家供應商綁死。呢個係採購風險,唔係技術問題。
粵語會令系統出事嘅四類句子
廣東話嘅錯,唔係「聽唔到」咁簡單。係「聽錯一個音,成句意思歪咗」。
大廠雲端語音服務嘅官方語言清單通常都有粵語代碼,例如 yue-HK(見 Google Cloud 語音辨識語言清單,查閱日期 2026-10-25)。但語言清單唔會話你知佢點處理同一句入面嘅語言切換。呢啲位只能靠測試。
| 難點 | 客戶原話示例 | 會錯喺邊 | 驗收要點做 |
|---|---|---|---|
| 中英夾雜 | 「我想 cancel 上個月嗰個 order」 | 直譯變查詢,唔係取消 | 每句放一個英文動詞 |
| 港式英文 | 「你哋個 app 點解 login 唔到」 | 英文詞被當成中文近音 | 用真實功能名測 |
| 數字與單位 | 「續約兩年,每月三百八十八元」 | 漏萬位,小數拆成兩個數 | 每段放一句含金額 |
| 懶音 | 「你哋個 app 點解 login 唔到」 | 辨識結果偏常見詞 | 用日常懶音重錄一次 |
例如,同一句「login 唔到」,用標準音講同用懶音講,辨識引擎嘅輸出可能完全唔同。呢個唔係 bug,係語言本身嘅樣。
驗收句要自己寫。 通用測試句唔會踩中你行業嘅專有名詞。做法好簡單:最近三個月嘅真實通話,隨機抽 20 句,每句改一個位做測試稿。測試稿點砌、評分表點用,粵語語音 Agent 測試指南嗰篇寫得更細。
延遲預算:由講完到出聲嘅五段
延遲預算 係指你事先定一個「客人講完到聽到回應」嘅上限,然後將呢個上限分配落下面五段,每段各自有目標。
| 段落 | 量度嘅係咩 | 影響 |
|---|---|---|
| 收音 | 由客戶講完到音頻送到服務端 | 網絡同裝置會食晒後面所有優化 |
| 句界判定 | 由最後一個字到系統決定「講完」 | 粵語停頓偏長,呢段最容易超標 |
| 語音辨識 | 第一段部分結果出現嘅時間 | 決定幾時可以開始諗 |
| 回應生成 | 收到文字到第一個回應單位出現 | 決定幾時開始講 |
| 語音合成 | 文字到第一個音頻位元出現 | 決定客人幾時聽到第一個字 |
公開研究亦提醒咗同一件事:對話系統最常見嘅兩個問題,一個係唔知幾時應該開口,一個係打斷得太急(Talking Turns,arXiv:2503.01174,2025 年 3 月)。即係話,句界判定唔單止影響延遲,仲影響對話自然度。
點解要逐段量? 因為客戶感覺到嘅慢,係五段加埋嘅結果。你唔拆開,就唔知道邊一段值得改。用平均數更加唔得 —— 用家記住嘅係最差嗰幾次。
分段量度方法有兩個選擇:由服務端逐段打點,或者由用戶端只計總時間再逐段推。前者準,後者貼近用家體感。兩套都要有。
想知點樣落手做一份可以貼上團隊嘅延遲預算表,睇語音 Agent 延遲預算。要比較分段式同一體化嘅取捨,Voice Agent 架構指南嗰篇有決策樹。
每通話成本:語音辨識按秒、語音合成按字符
客服嘅成本有兩塊,計法唔同,唔好溝埋計。
語音辨識 按音頻時長計。港嘢嘅公開費率係 HK$1.40/音頻小時,按秒計、只計成功音檔。語音合成 按字符計入方案配額。
【原創數據】 以下係港嘢現行公開定價(2026-10-25 查閱):
| 方案 | 月費 | 每月字符 |
|---|---|---|
| 輕量 | HK$58 | 60,000 |
| 入門 | HK$128 | 200,000 |
| 專業 | HK$338 | 600,000 |
| 工作室 | HK$688 | 1,400,000 |
一通三分鐘嘅電話,辨識成本大約係 3 ÷ 60 × HK$1.40,即七毫左右。合成嗰邊,如果每通回覆約 150 字,日行 200 通就係 30,000 字。
成本嘅真正槓桿唔係價格,係幾長嘅回覆。 回覆由一句變三句,合成成本就乘三;而家你仲未計客戶聽耐咗先講完嗰幾秒。設計台詞時,答案要短,但關鍵資訊要覆述。
每通話嘅完整算式,我哋喺AI 客服每通話成本嗰篇逐項拆;如果你想先睇攤分例子,港嘢定價頁有現成數字。
打斷:用戶插嘴時要即刻收手
Barge-in 係指客人喺系統講緊嘅時候插嘴,系統要即刻收手,唔好繼續講落去。
呢個位最常見嘅三個錯:
- 等答完先停 — 客人已經講咗「等一下」,系統仲照講。體感上就係「唔聽講嘢」。
- 淨係停生成,唔清緩衝 — 已經合成咗嘅音仲會播埋尾。
- 用音量做唯一判斷 — 收音、咳嗽、背景人聲全部會當成插嘴。
公開嘅全雙工語音評測跑過 293 段模擬對話、1,200 次插嘴、超過 40 小時生成語音,結論係現有模型面對插嘴仍然有明顯問題,尤其喺噪音同頻繁打斷嘅環境(見 FD-Bench,arXiv:2507.19040,2025 年 7 月)。另一份工作直接提出用三個系統層指標評估語音互動:barge-in、句尾判定準確率、端到端延遲(見 FireRedChat,arXiv:2509.06502,2025 年 9 月)。
成個處理流程同埋啲「似插嘴但其實唔係」嘅邊界位,睇用戶插嘴點處理。
Warm transfer:幾時放手、要帶咩脈絡
Warm transfer 係指 AI 同真人之間轉接時,將已知的脈絡一齊帶過去,客人唔使由頭再講一次。
要帶嘅嘢好具體:已經確認咗嘅身份資料、客戶講過嘅查詢重點、系統已經查過嘅結果、客戶嘅情緒狀態。仲有轉接嘅原因(系統唔識、客戶要求、規則觸發)。
最傷嘅轉接時機係「答到一半」。 客人講緊,系統轉真人,客人要重講。改法好簡單:先答一句「我幫你轉交同事」,等客人知道咩事,然後先轉。
轉接嘅設計、交接位嘅分工、量度指標,睇AI+真人混合客服。
合規:PDPO 之下三條唔可以後補嘅規則
香港嘅《個人資料(私隱)條例》(PDPO)係科技中立、原則導向嘅,適用於公私兩部門(見 個人資料私隱專員公署:條例一覽,查閱日期 2026-10-25)。語音客服冇豁免,而且錄音、逐字稿、聲紋都係個人資料。
| 規則 | 落地做法 |
|---|---|
| 錄音告知 | 接通時講明會錄音、用途、保存安排;提供唔接受嘅處理方式 |
| 保留期 | 錄音同逐字稿分開管理;到期刪除並保留刪除紀錄 |
| 投訴轉真人 | 客戶表明要投訴、情緒升溫或涉及金額爭議即刻轉 |
另外三樣係設計上要預留嘅:關鍵資訊(金額、日期、身份)一定要覆述確認;信心唔夠就主動問一次;所有轉接同修正紀錄都要留低,方便日後改流程。
逐條對落語音 AI 場景嘅自查清單,睇Voice AI 合規指南。
上線四步:由一條熱線開始
一次過重做整個客服中心,風險最高。呢四步係按風險由細到大排。
01 · 場景切分 — 用最近三個月嘅通話紀錄,揀一個高重複、低風險、答案穩定嘅查詢。
02 · 台詞庫 — 把核准答案寫成短句台詞,逐句生成、試聽。同步準備「聽唔明」「要轉真人」嘅句。
03 · 試點 — 先喺一條非繁忙時段嘅熱線試行。量度完成率、轉真人率、客戶評語,唔好只睇辨識準確度。
04 · 監察 — 每週覆聽抽樣通話,更新台詞同詞庫;設定異常警報,唔好等系統靜靜地壞咗。
【獨家觀察】 試點期最有用嘅一項數據,唔係完成率,係「客人幾多次講咗同一件事兩次」。嗰個數字就係你嘅台詞問題清單。
常見問題
同傳統 IVR 有咩分別?
IVR 係「撳 1 轉 1」,語音方案係「講得出就跳得啱」。分別唔只喺收音,而喺後續處理:可以聽明一句包含多個條件嘅查詢,仲可以將對話摘要交畀人手跟進。選單層級同提示語設計,粵語 AI IVR 指南嗰篇有完整拆解。
聽錯咗點算?
關鍵資訊一定要覆述確認,例如金額、日期、身份資料。信心唔夠就主動問一次,仍然唔清楚就轉真人。沉默同亂答,比多問一句更傷體驗。
要唔要換電話系統?
唔一定。常見做法係喺現有平台上面加一層語音:電話系統負責接聽同播放,語音服務負責辨識、判斷同生成。實際接入方式視乎你嘅電話平台支援唔支援串流或者播放自訂音頻。
幾錢開始?
可以由一條熱線、一個場景開始。語音辨識按音頻時長計,語音合成按字符計。成本隨通話量同回覆長度變,唔係一個固定月費。
客戶聽得出係 AI 嗎?
冇人保證聽唔出,唔建議以此為目標。實務上應該主動告知對方正在同語音系統對話,並且提供轉真人嘅選項。台詞寫得短、口語化、少用書面長句,聽感會自然好多。
想試下自己嘅場景?
最直接嘅做法係拎你自己嘅台詞試一次。
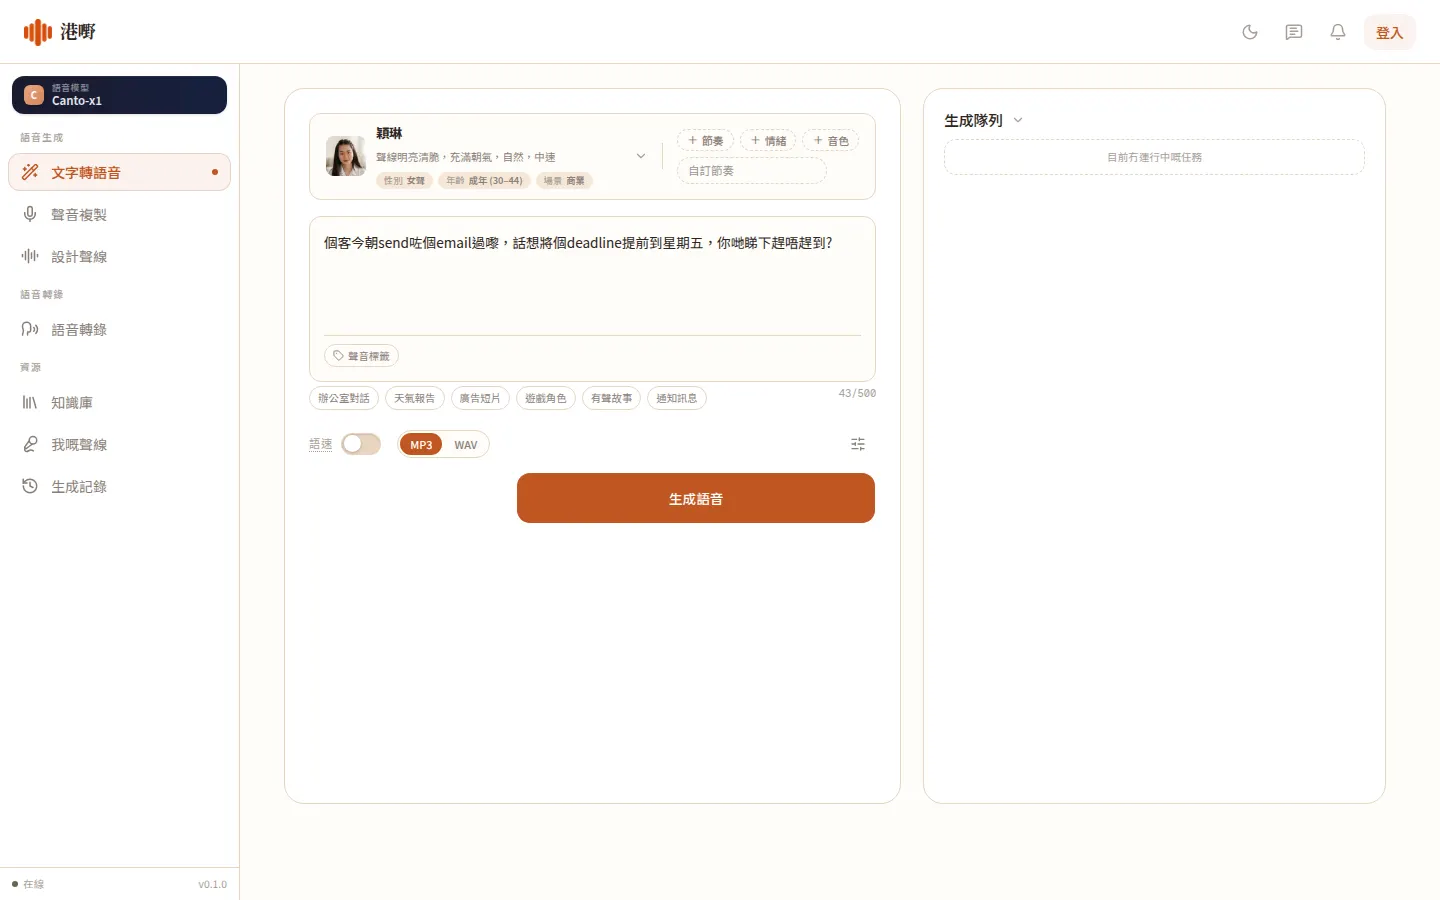
港嘢嘅 playground 可以直接貼稿試聲;想知道 API 契約、限額同長音檔做法,睇開發者文件。想了解我哋背景,可以喺「關於港嘢」一頁睇;有技術問題或者想申請功能開通,歡迎聯絡我哋。
本文由港嘢內容團隊編輯審閱(editorial review,2026-10-25)。文中嘅第三方研究同公開定價資料,連結查閱日期已標明;未喺你嘅網絡同電話平台實測嘅數字,本文唔會當成保證值。